
Сайты и API
Внешние HTTPS-проверки, время ответа, содержимое ответа и срок TLS-сертификата.
Разработали независимый центр мониторинга. Состояние сайтов, серверов и API, реальные ошибки и уведомления собраны в одной панели.
По данным работающего сервиса на 30 сентября 2026
Сбой подтверждёнсобытие попадёт в очередь
О проекте
За пользовательским действием стоят backend, база данных, внешние API и фоновые задачи. Главная страница может открываться, пока поиск, оплата или создание документа уже возвращают ошибки.
Собрали разные уровни наблюдения в одну систему. Команда видит продукт целиком, раскрывает его проверки и компоненты, находит связанные серверы и отслеживает подтверждённые сбои.
Внешние HTTPS-проверки, время ответа, содержимое ответа и срок TLS-сертификата.
CPU, память, место на диске, базы данных, фоновые задачи и сигналы резервного копирования.
Запросы и ошибки провайдеров, клиентские операции и история за выбранный период.
Подтверждение сбоя, отметка о работе над ним, восстановление и очередь Telegram-уведомлений.
Интерфейс
Показали сервисы, серверы и компоненты как связанные части системы. В каждой точке видно состояние, время последнего измерения и статистику за выбранный период.
Состояние продуктов и инциденты
Сайт, API, операции и зависимости
Запросы, ошибки и время ответа
Взять сбой в работу и следить за восстановлением
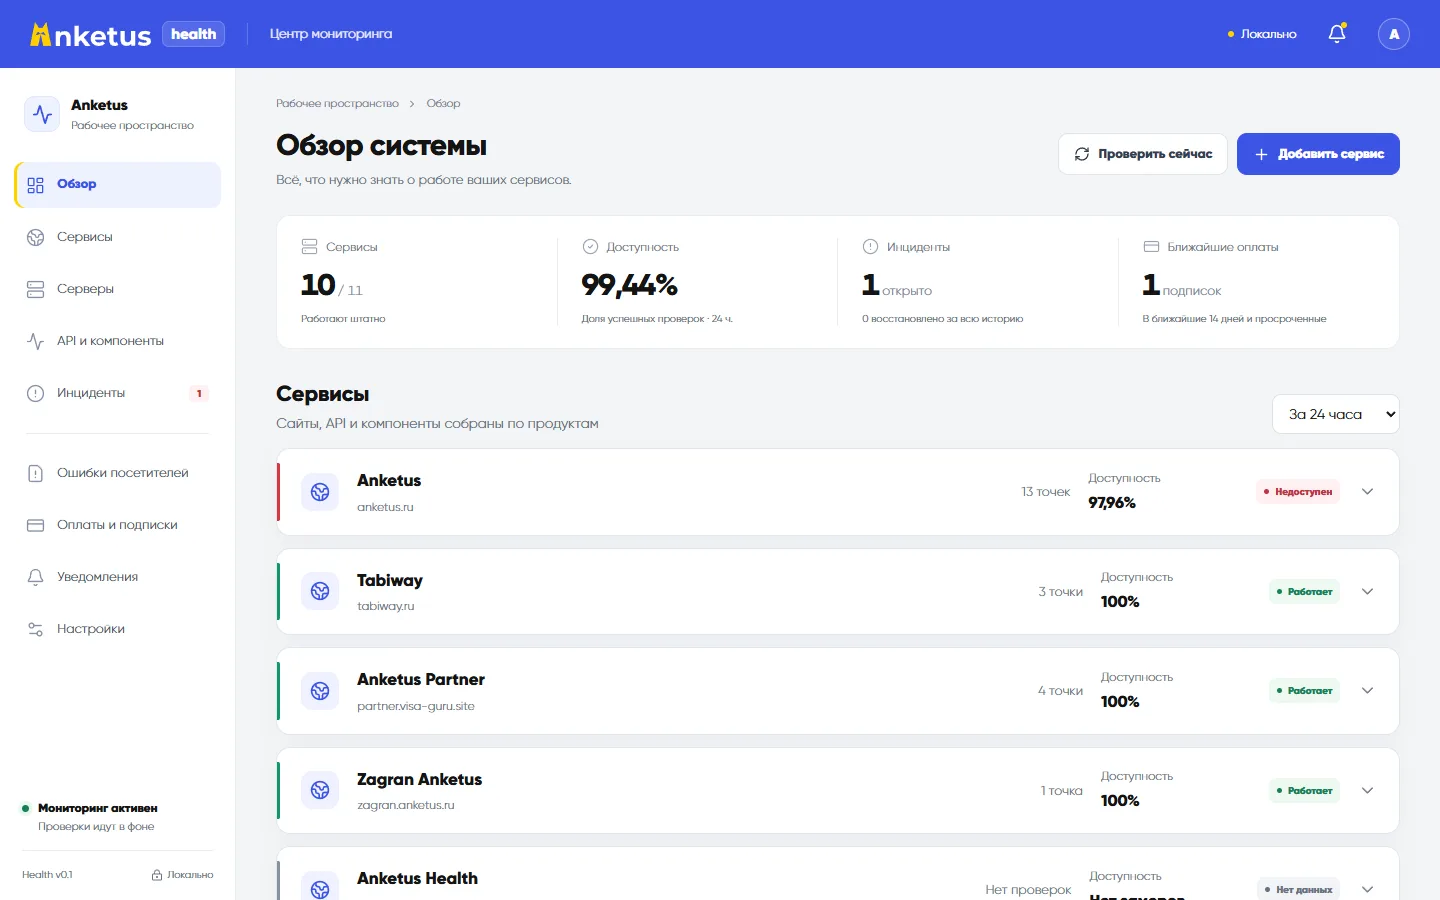
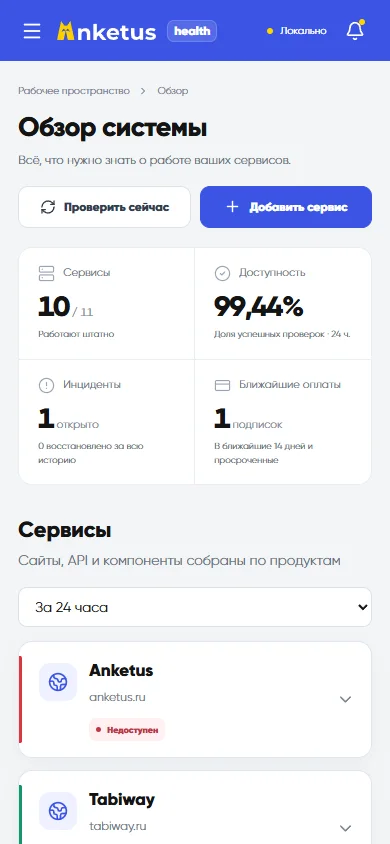
Сайты, API и компоненты сгруппированы по сервисам. В обзоре видны успешные проверки, открытые инциденты и ближайшие сроки продления подписок.
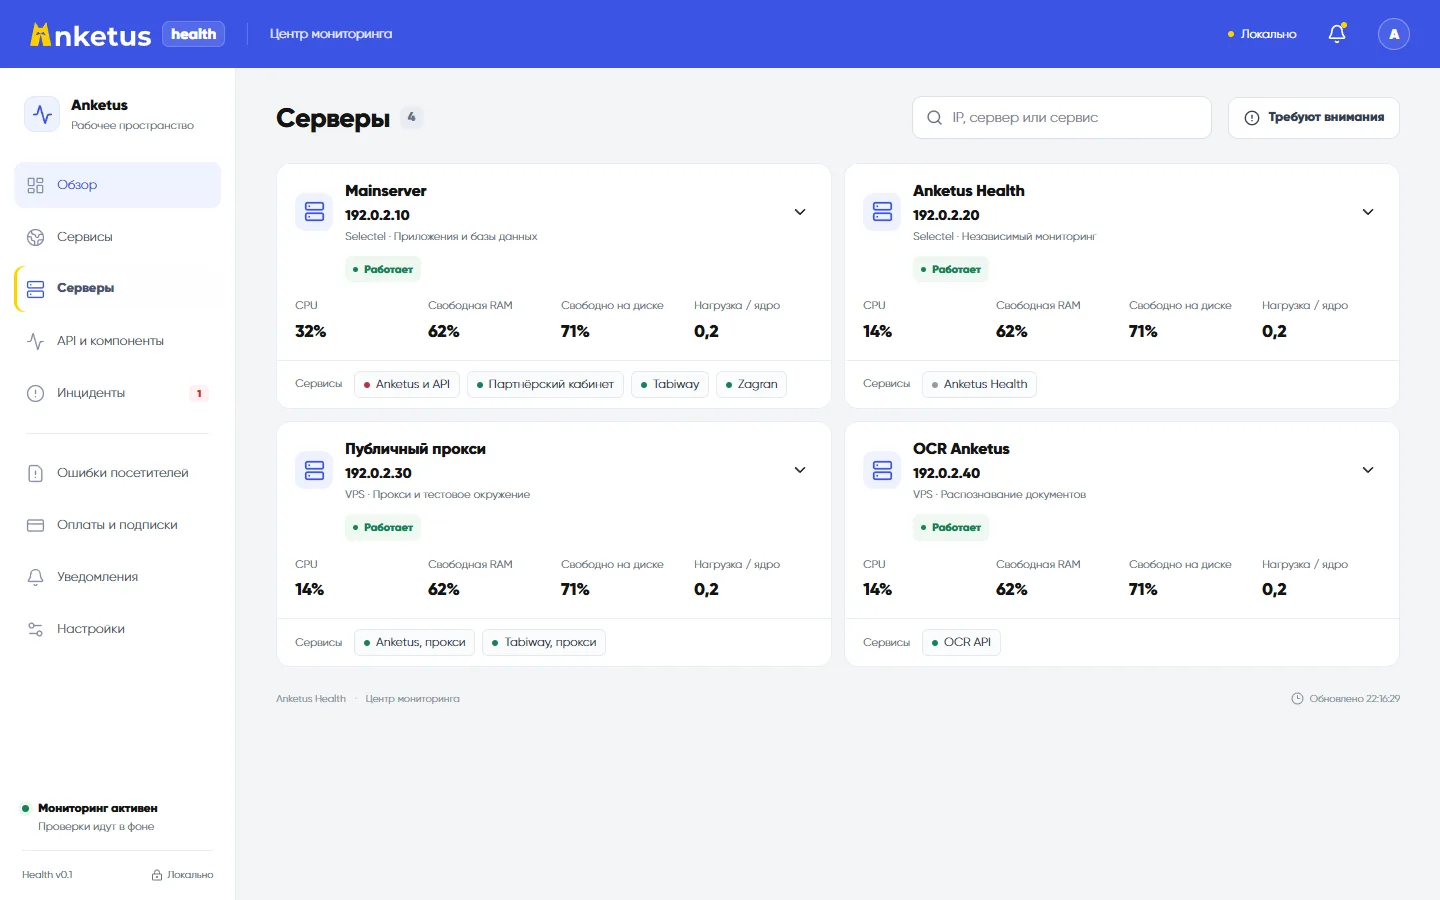
Карточка сервера показывает нагрузку, свободную память и место на диске. Здесь же видны размещённые продукты: можно перейти к их проверкам и связанным компонентам.
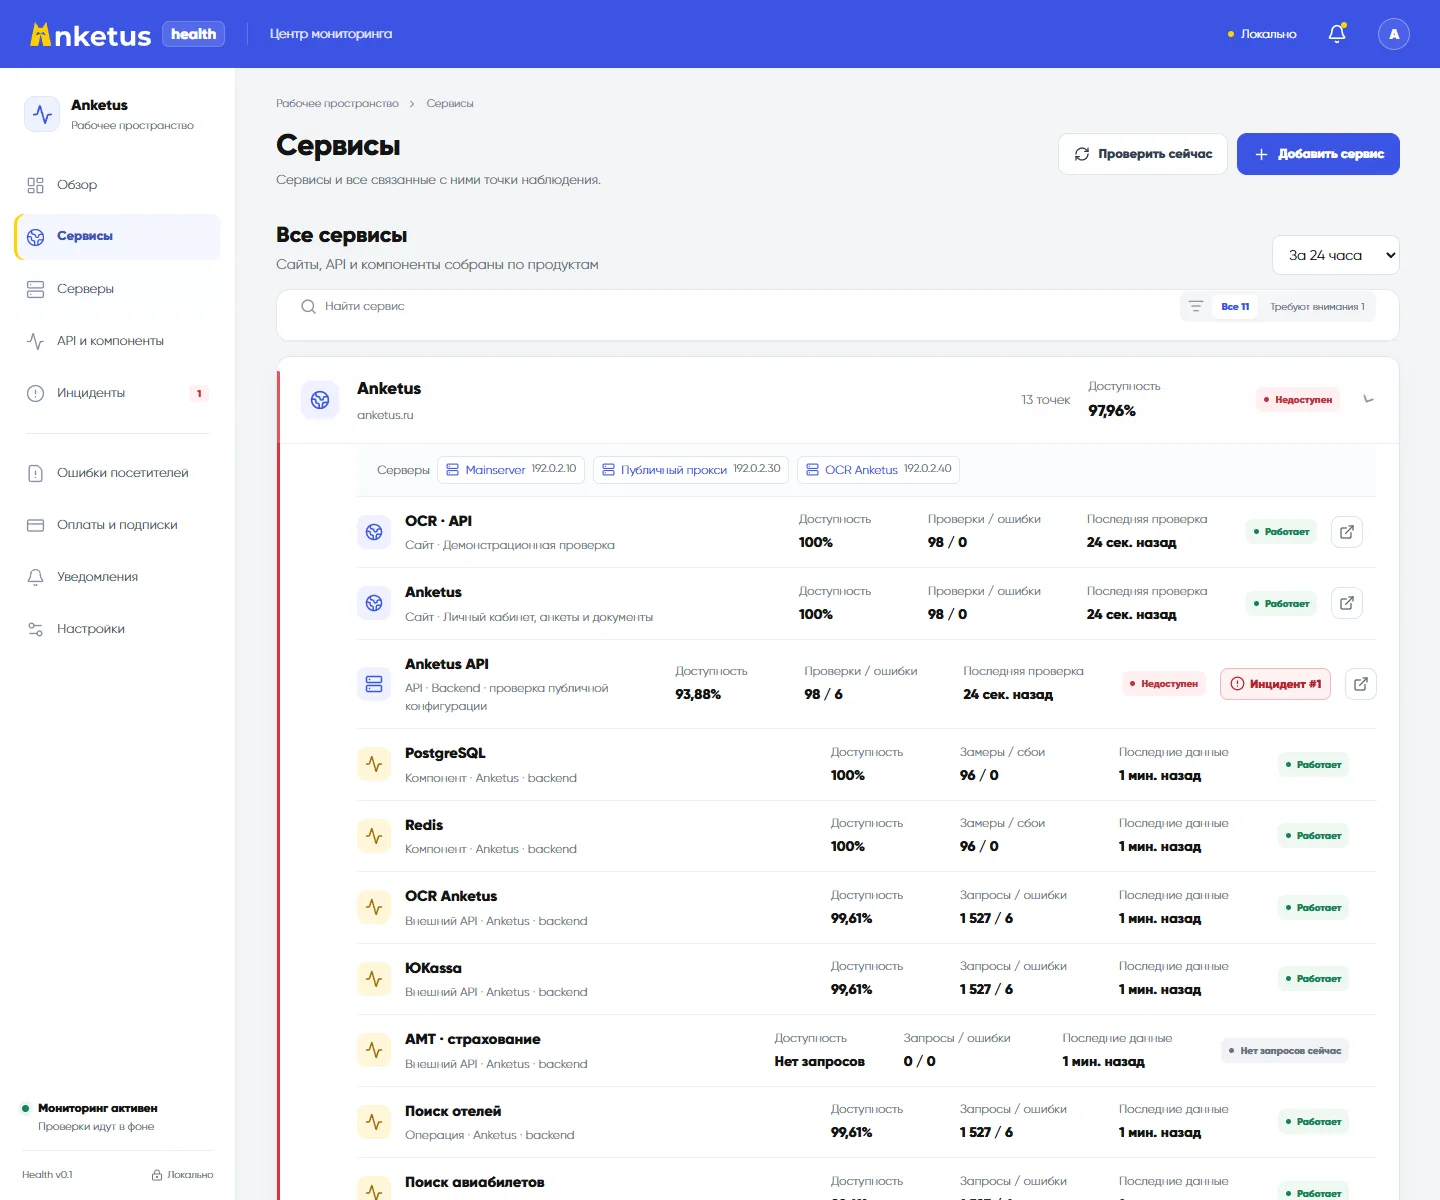
Периоды 24 часа, 72 часа, неделя и месяц помогают сравнить наблюдения. У HTTP-проверок показаны замеры и ошибки. Для подключённых операций и API доступны количество запросов и их исходы.
Работа со сбоями
В инциденте сохраняются начало, причина и восстановление. Можно отметить, что сбой уже взят в работу, и оставить комментарий. Очередь уведомлений показывает статус доставки и попытки отправки.
Открыть вход в платформу , в новой вкладке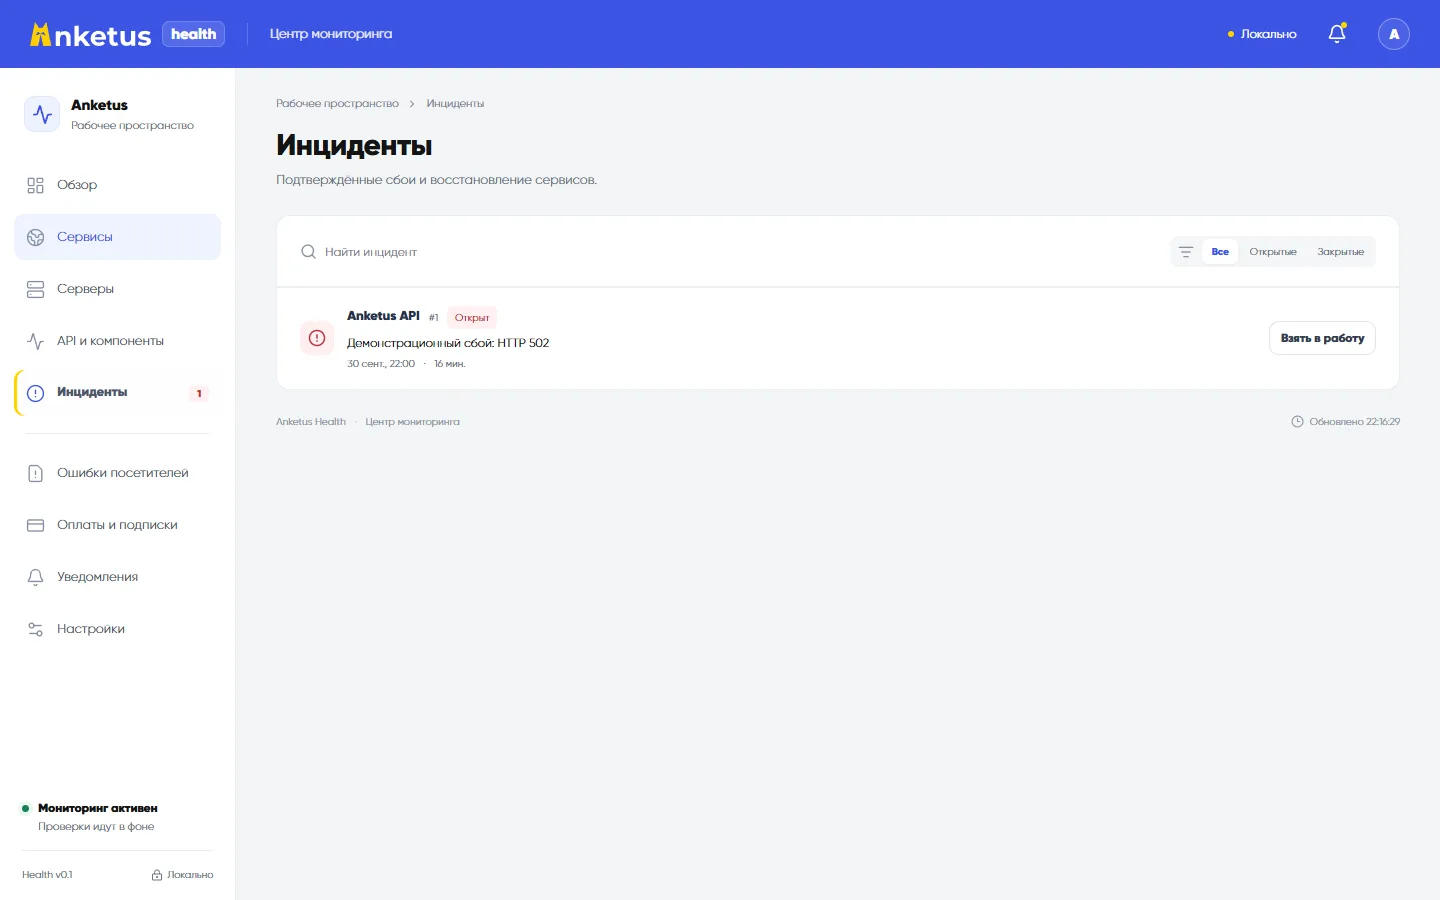
Как работает
Независимый сервер проверяет публичные адреса и принимает измерения приложений и инфраструктуры. Это помогает видеть внешний ответ сервиса и то, что происходит внутри.
Внешние HTTPS-проверки
Метрики Linux-сборщиков
Реальные операции и ошибки
Отдельный сервер
История, правила подтверждения и инциденты
Состояние и статистика
Очередь и доставка в Telegram
Пассивное наблюдение за API показывает исход реальных вызовов. Если обращений не было, панель сообщает об этом. Если источник перестал передавать измерения, данные помечаются как устаревшие.
Измерения пришли, но вызовов провайдера не было
Источник давно не передавал телеметрию
Ошибки прошли порог подтверждения инцидента
Разработка
Сложности были в достоверности статусов, доступе к инфраструктуре, защите проверок и доставке повторяющихся событий. Эти правила заложили в backend и сбор данных.
Разместили панель отдельно от основных приложений. Внешние HTTP-проверки дополняются телеметрией из backend и Linux-сборщиков. Источники отправляют только разрешённые им компоненты и числовые метрики по собственным ключам. Сборщику не нужен доступ к Docker socket.
По умолчанию инцидент HTTP-проверки открывается после трёх последовательных ошибок, а восстановление подтверждается двумя успехами. Пороги настраиваются. Отсутствие запросов к провайдеру и пропажа телеметрии имеют отдельные состояния. Техработы исключаются из статистики и переходов инцидента.
Вход защищён паролем и обязательным TOTP или одноразовым резервным кодом. Для запросов предусмотрены серверные сессии, защита от подделки и ограничения частоты. HTTP-проверки принимают только разрешённые HTTPS-адреса, блокируют внутренние IP и не переходят по редиректам.
Инциденты, измерения и очередь уведомлений сохраняются в SQLite. Повторные события объединяются, неудачная отправка в Telegram повторяется с увеличением задержки. Ошибки посетителей передаются в ограниченном формате: код, операция и версия, без текста исключений, паспортов и содержимого форм.
Результат
Команда получила единую панель с внешними проверками, телеметрией серверов и компонентов, историей инцидентов и статистикой операций.
Активные проверки сайтов и API
Все четыре передают свежую телеметрию
Подключённые источники уже передали измерения
Сохранённые внешние проверки с 15 сентября
Записи телеметрии в сохранённой истории
24 часа, 72 часа, неделя и месяц
Число проверок, серверов, компонентов и записей истории проверено по данным работающего сервиса на . Замеры компонентов и HTTP-проверки посчитаны отдельно. Это объём наблюдений мониторинга. Доля успешных проверок в интерфейсе рассчитывается по измерениям; количество запросов показывается только для источников, передающих эту метрику.
От общего состояния продукта можно перейти к его API, зависимостям и серверу. Подтверждённые ошибки сохраняются в истории, а восстановление фиксируется после успешных проверок.
Следующий продукт
Разберём инфраструктуру, сигналы и работу команды со сбоями
